
 下载APP
 报料
 关于

刘镇东 湖南日报·新湖南客户端 2026-09-16 20:15:55
湖南日报全媒体记者 刘镇东
刚刚过去的暑假,中南林业科技大学涉外学院环境设计专业大三学生刘浩男,和团队一直在“死磕”模型精度。当电脑屏幕上那个数字终于停在他们满意的数值,大家欢呼雀跃。
这名还在读大三的年轻人,带着一支由中南大学、湖南大学、华中科技大学研究生组成的团队,研发出支持中文、英文、日文三种语言的“语鉴全球AIGC检测模型”。前不久,他们将模型送检湖南省软件评测中心。检测报告显示:盲测30万条中英日三语样本,AI文本总体召回率达到99.959%,人类文本总体误报率为0.135%。
“我们一次成功了。”刘浩男说,这一精度远高于目前市场上的同类产品,尤其是在人工文本误报率和AI改写识别方面,优势明显。
从“被AI震撼”到“想造一把尺”
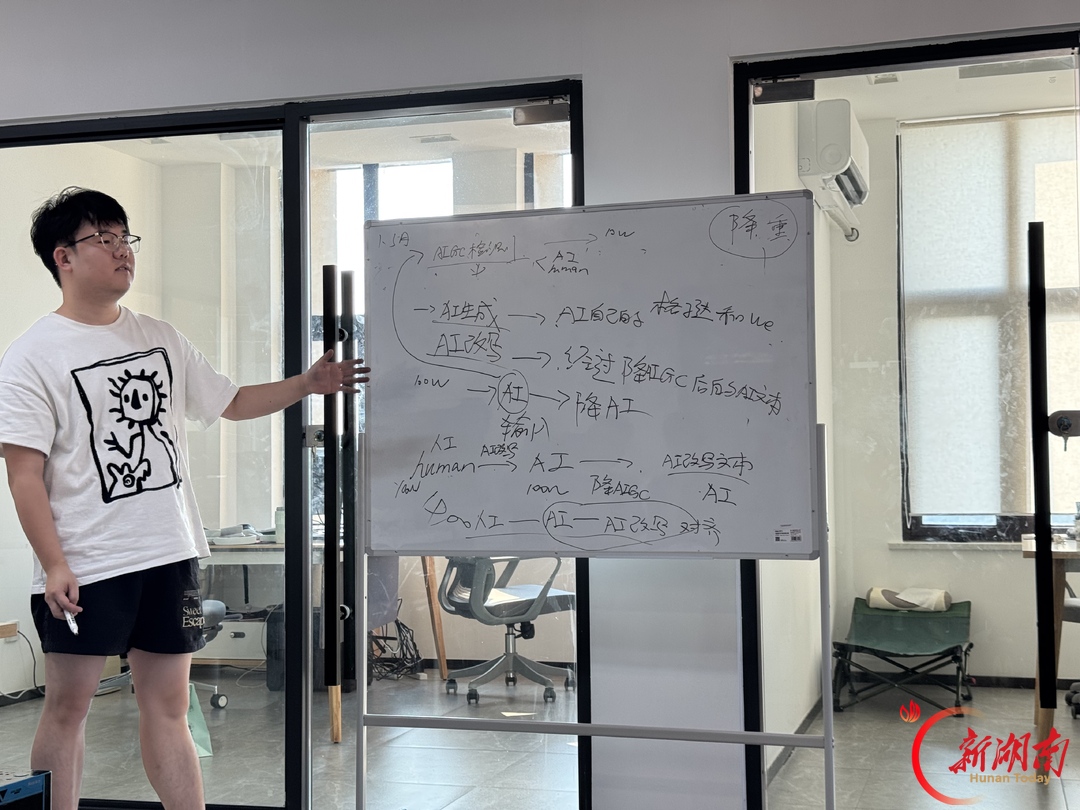
刘浩男对AI真正产生兴趣,始于今年年初第一次使用Codex、Claude相关模型。“第一次用的时候,有被震惊到。”他回忆,当时他让AI帮忙解答一个学习问题,对方不仅回答精准,还能给出完整的推导过程。
真正让他把兴趣变成行动的,是今年4月的一份课程作业。老师要求用AIGC检测工具查重,刘浩男盘点了知网、维普、万方、中科锐鉴、腾讯朱雀等市面产品,却发现这些工具“问题不小”。“《滕王阁序》被判定为AI生成,《荷塘月色》也被标红了。”他举例说,很多明明是人工写的文本,被误判成AI;而一些AI生成的内容,反而查不出来。
而且如今大学生论文中存在一种现象:用AI写完整篇论文后,再用“降AI率”工具改写,就能轻松绕过检测。他说,“这本质上就是学术不端,但现有的工具拿它没办法。”
作为环境设计专业的学生,刘浩男也感受到AI对设计行业的冲击。“Image2生成的效果跟实拍几乎一模一样。如果不转型,毕业可能就失业了。”他开始自学机器学习,脑子里冒出一个想法:能不能做一个更精准的检测模型?
在学校彭梦老师的鼓励下,他找到华中科技大学硕士毕业的贺兴智,又拉上同校软工专业的刘承远和张泽熙,几人决定一同推进这个项目。同时,还有学校信工院的杨露教授、中南大学的夏利民教授、华中科技大学的苏曙光教授担任咨询顾问。
真正投入后,他们才发现AIGC检测没有捷径。模型过拟合、AI召回率与人工误报率难以兼顾、代码算子兼容故障……每试一条方向,都要耗费大量数据、算力和时间,而大部分版本跑出来效果都达不到要求,前后迭代了近1000个版本,终于做出1.0版本,对中文的识别精度总体表现不错,和知网、维普基本持平。
今年6月,他们成立长沙光子引擎科技有限公司。起初想取名“光子创新”,“光子”取光速、精准之意,也契合文本信息识别赛道;最后定为“引擎”,定位为产业级底层技术底座。
114平方米里的5000多个版本
创业初期,资金是最大的难题。
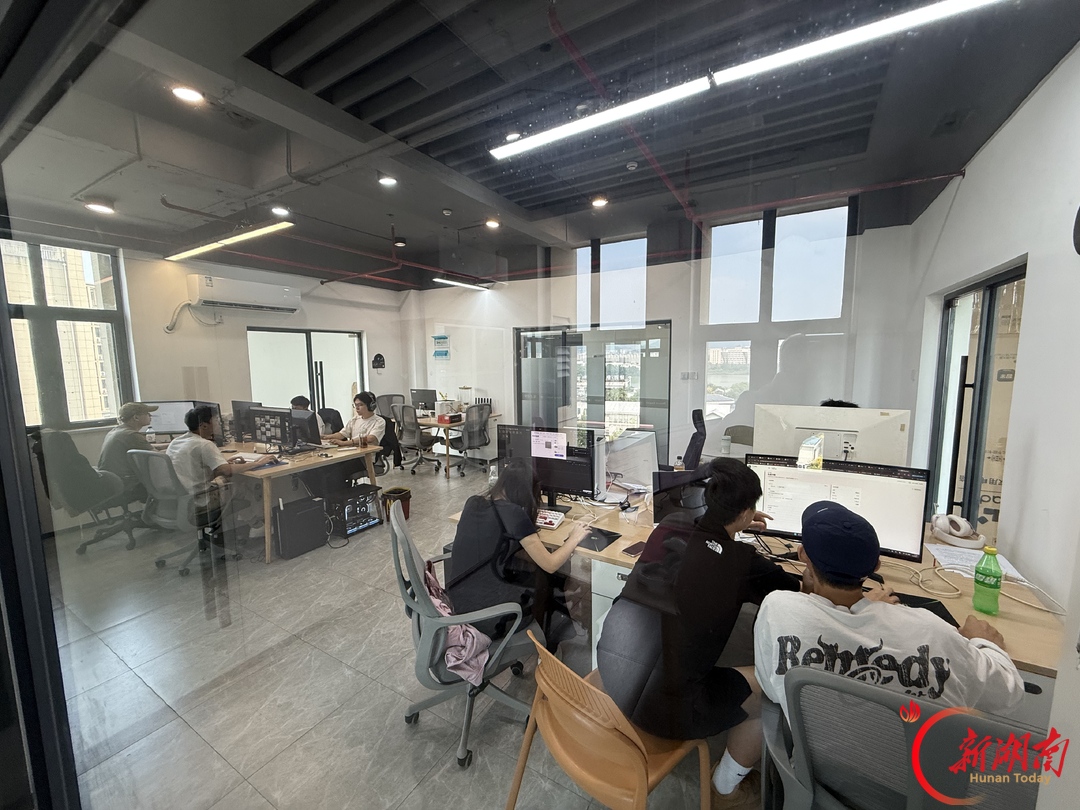
团队1.0版本对外部署了大约10个模型,首批营收5万多元;后续开放API,又带来近10万元收入。这笔钱看着不少,但租下麓山科创基地一间114平方米的办公室后,很快就见了底,一个月租金七八千元,还要买设备、租算力。刘浩男告诉记者,没有用免费的政府办公场地,是因为免费场地大多是开放式的,没办法敞开讨论,也担心数据和隐私安全。那段时间,每一分钱都要省着花。
初期训练都是靠团队成员的个人笔记本,但受算力和显存限制,速度很慢。刘浩男向学校反映后,信工院先后提供了一台40G算力服务器,又协调传媒与设计学院出资10万元租用算力,并抽调机房4台A100服务器,彻底解决了算力瓶颈。训练还需要大量各模型的AI样本,GPT和Claude价格不菲,苏曙光从自己课题经费中抽调4万元,购买了相关AI厂商订阅。
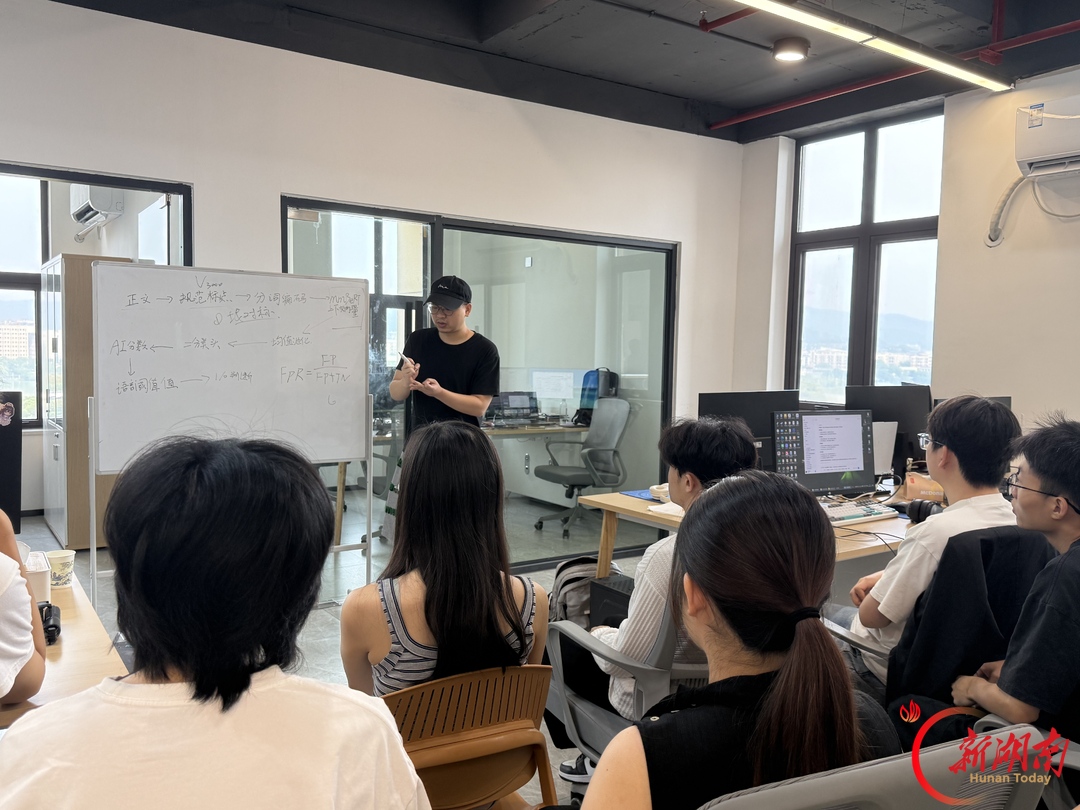
团队内部也出现过“信任危机”,刘浩男把实际数据和成果摆出来,大家最终选择相信团队并坚定跟随。大家经常在白板上吵方向,但吵归吵,最后总能吵到对的路子上。记得有一次,大家从中午开会到傍晚,争论是分兵做多个语言模型,还是合兵做一个多语言模型,争论了3个小时。
最后刘浩男拿出调研报告:国内市场很大,日语还是一片蓝海,没有成熟产品。与其分兵,不如合兵做一个超高精度多语模型。晚上,他带大家看了《四渡赤水》,又去中建智慧谷散步,看着花园独栋办公楼说:“兄弟们,咱们一年内也要拿下属于咱们自己的楼。”那一刻,团队凝聚力达到顶点。
技术攻坚远比想象中艰难。团队前后迭代5000多个模型版本,最终版本内部代号v5078是现在精度最高的模型。在这过程中,刘承远和张泽熙曾定下一条原则:宁可漏掉一部分AI文本,也不能冤枉一个真人。“一篇论文背后,可能是一个学生熬过的无数个夜晚。如果被一句‘疑似AI生成’轻轻否定,对他来说是很重的打击。”所以从第一天起,“低误报”就排在“高召回”前面。
最磨人的不是失败,而是“假的成功”。有些版本在测试集上分数很好看,换一批数据一测,结果却掉了下来。他们意识到,模型可能只是学会了“背答案”。于是立下规矩,每次实验改了什么、为什么没成,都记进台账。台账越记越厚,失败的版本一个个排在上面,正是这些失败,一步步把团队推向正确方向。
他们办公室的灯常亮到深夜,十一二点甚至凌晨两三点是常态。早期租算力按小时计费,不用也花钱,他们便设好脚本让设备彻夜跑模型。“有一回模型卡住,几台设备白跑一晚,我们心里在滴血”。刘浩男说。
一次便通过的盲测
“送检一次很贵,一项指标就要几千块钱,每一分钱都要花在刀刃上。”刘浩男说,为确保通过,他们提前用各种权威数据库做了大量自测,只为确保评测能一次就达到满意的效果。好在最后结果与他们自测时相差不大。
目前,模型还具备识别“降AI率”改写内容的能力,识别率约80%。同时,模型能自我迭代,导入新语料后,8小时就能自动学习,保证对最新大模型的识别精度。
对比知网、维普、万方、腾讯朱雀等主流产品,团队最大的优势,不仅是国内首个多语言AIGC检测模型,还对AI改写有很强的识别度,能识别AI降重,这是同类产品所不具备的。比起成熟厂商,他们赛道更垂直,也有属于大学生的冲劲——在500多次失败中不服输,对失败诚实,对数据敬畏。
商业化方面,团队主推私有化部署。“有些单位数据不能外流,我们把模型加密后放到他们本地,他们既能保证数据安全,我们也能保护知识产权。”刘浩男说,目标客户包括高校、新闻媒体、出版单位和政府相关单位。高校学生查一次AIGC动辄一两百元,如果部署模型,后续维护费十几万元,学生就可以免费使用。
“我们的模型精度很高,学校也会帮我们推动落地。”刘浩男说,团队正在为参加中国国际大学生创新大赛等赛事做一系列准备。
现在,团队从最初的5个人慢慢增加到13人。未来,他们想先深耕中文市场,再拓展英文、日文市场,刘浩男说,“就像农村包围城市一样,一步步占领市场,梦想成为世界一流的AIGC检测服务商。”
“创业后最大的改变,是本来迷茫的未来多了那么一点点自信。”刘浩男说,这份自信来自失败积累的经验,也来自团队做出来的成果。“我们相信,AIGC检测会是未来的刚需。而我们,正在做一件有意义的事。”
责编:刘镇东
一审:刘镇东
二审:余蓉
三审:黄京
来源:湖南日报·新湖南客户端
版权作品,未经授权严禁转载。湖湘情怀,党媒立场,登录华声在线官网www.voc.com.cn或“新湖南”客户端,领先一步获取权威资讯。转载须注明来源、原标题、著作者名,不得变更核心内容。
我要问
 湘公网安备 43010502000374号